Seed Audio 1.0 Générateur audio IA
Mettez en scène le son, au-delà d’une simple voix off. Décrivez les interlocuteurs, les repères temporels, l’ambiance et les interventions musicales dans un seul brief textuel. Chaque MP3 mixé à 44,1 kHz reste privé, et le coût exact en crédits s’affiche au préalable.
- 14 crédits par prise
- MP3 à 44,1 kHz
- Audio guidé par la scène
- ByteDance · Seed Audio 1.0 documentation ↗
Créez avec Seed Audio 1.0
Exemples de scènes avec Seed Audio 1.0
Voix · Commentaire sportif d’un moment décisif
Prompt
30 seconds left. They're down by one. This is everything. He picks it up on the right wing. Look at that speed—through, past two defenders. He shoots—GO! In the dying seconds, a 17-year-old has just rewritten history. Remember this moment. You were here when a legend was born.
Principales fonctionnalités de Seed Audio 1.0
Scènes sonores à partir d’un seul prompt
Définissez les dialogues, l’ambiance et les interventions musicales ou les effets sonores dans un seul brief textuel. Vous obtenez un unique MP3 mixé, et non une simple lecture TTS à assembler ensuite.
Quand utiliser Seed Audio 1.0
Vidéo IA et doublage
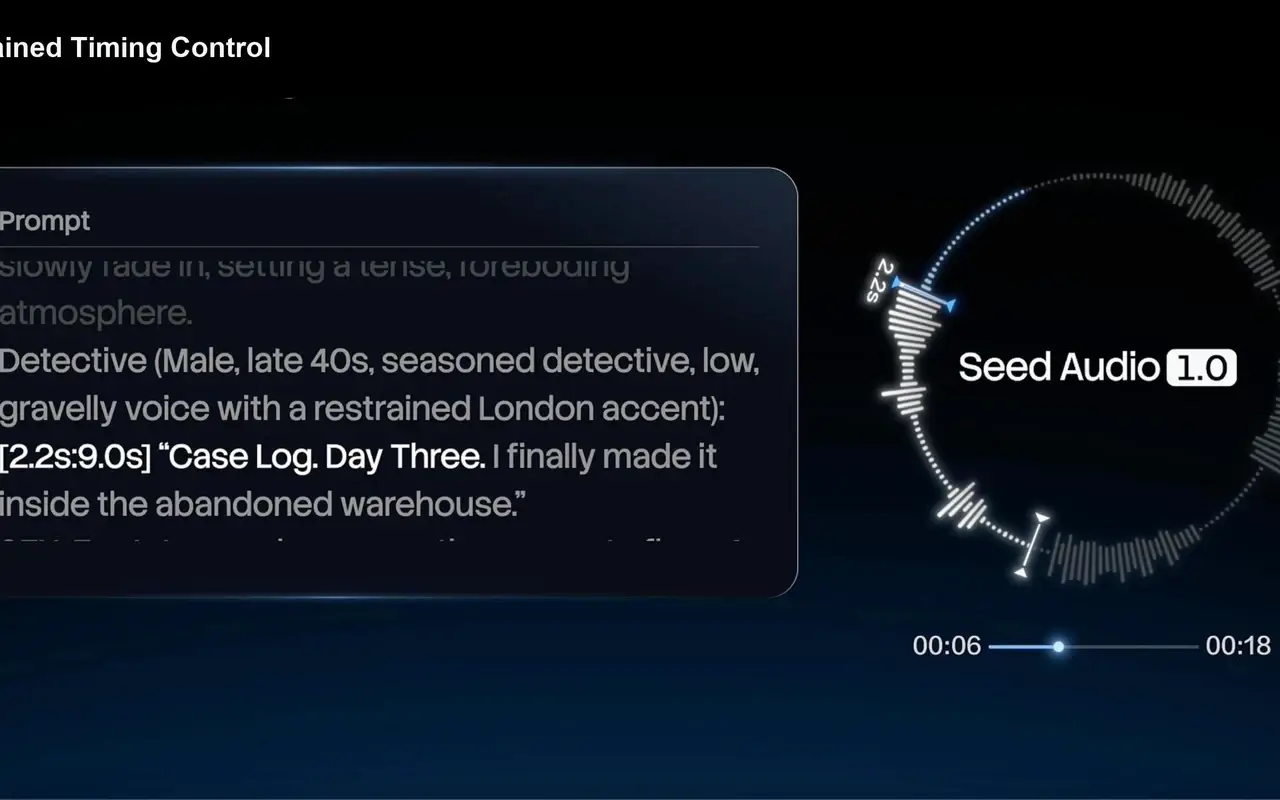
Ajoutez des dialogues et des fonds sonores à une vidéo IA muette ou à des storyboards. Utilisez des repères temporels comme [2.8s:8.4s] pour caler les répliques sur les coupes avant le mixage final.
Publicités et formats courts
Produisez une voix off avec ambiance de pièce, effets sonores et passages musicaux dans une seule piste mixée, au lieu de passer d’un outil de synthèse vocale (TTS) à un outil de musique ou de bruitage.
Maquettes audio pour podcasts et jeux
Ébauchez des échanges à plusieurs voix, des fonds sonores et des ouvertures narratives sans préambule sous forme d’audio provisoire, avant de réserver un studio ou d’enregistrer une voix off.
Usages adaptés / Usages à éviter
Idéal pour
- Voix dirigées, ambiance et indications musicales dans une seule prise mixée
- Séquences horodatées à plusieurs voix dans un seul brief
- Distribution vocale définie par texte, sans bibliothèque de voix
- Fonds sonores provisoires ou de prévisualisation pour des montages à l’image verrouillée
Inadapté à
- Voix prédéfinies nommées ou courtes voix off avec balises d’émotion (utilisez Eleven v3)
- Clonage vocal, images de référence ou voix de référence importées
- Assistants conversationnels en temps réel ou à faible latence
Comment utiliser Seed Audio 1.0
1. Décrivez les différentes couches sonores de la scène
Suivez cet ordre : scène et atmosphère, interlocuteurs, émotion, dialogues entre guillemets, puis ambiance, musique de fond et effets sonores. Précisez la langue des répliques si nécessaire. Si vous le souhaitez, préremplissez depuis un exemple ou une fonctionnalité clé : rien ne se lance tant que vous ne générez pas.
2. Précisez les voix et le timing
Précisez l’âge, le timbre et la diction de chaque voix, puis calez les répliques clés avec des plages comme [2.8s:8.4s] lorsque les moments importants doivent coïncider avec l’image ou les repères musicaux.
3. Générez, écoutez chaque couche sonore, puis affinez
Confirmez l’estimation de 14 crédits, générez, puis écoutez chaque couche sonore : voix, ambiance et musique. Corrigez d’abord le problème sonore le plus gênant, modifiez une partie du brief et relancez la génération avant de télécharger.
Tarifs de Seed Audio 1.0

Comparer Seed Audio 1.0Seed Audio 1.0 ou Eleven v3 : comparatif
Seed Audio 1.0
Ce modèleFonds sonores pour vidéos IA, scènes courtes et dialogues à plusieurs voix avec repères temporels
Audio vocal privé14 crédits par prise
Voix off courtes et interprétation de personnages avec balises d’émotion
Audio vocal privé7 crédits pour 1 000 caractères
Audio à une seule voix, guidé par des balises
Audio vocal privé6 crédits pour 1 000 caractères
FAQ sur Seed Audio 1.0
Qu’est-ce que Seed Audio 1.0 ?
Seed Audio 1.0 est le modèle de création audio de ByteDance pour les scènes sonores, et non un simple outil de synthèse vocale. La synthèse vocale classique (TTS) lit un script avec une voix choisie ; Seed Audio réunit les intervenants, le timing, l’atmosphère et les interventions musicales dans un seul brief pour produire une prise mixée unique. Sur MixVio, vous rédigez ce brief, puis générez un seul MP3 privé à 44,1 kHz, avec le coût en crédits affiché au préalable.
Quels types d’entrée MixVio prend-il en charge pour Seed Audio 1.0 ?
Cette version publique accepte uniquement du texte : un brief de scène de 2 048 caractères maximum. Il n’y a ni sélecteur de voix, ni import de références audio ou image, ni marqueurs @AudioN / @Image. Décrivez les personnages et leurs voix, les dialogues, l’ambiance et les interventions sonores directement dans le prompt.
Pour quels usages Seed Audio 1.0 est-il le plus adapté ?
Vidéos IA et doublage, publicités et formats courts avec voix off accompagnée d’effets sonores ou d’interventions musicales, ébauches de podcasts ou de jeux : partout où dialogues, espace et rythme doivent être réunis dans un seul brief textuel. Préférez Eleven v3 si vous avez besoin de préréglages nommés et de balises d’émotion pour de courtes voix off. Consultez les sections « Quand choisir Seed Audio » et « Adapté à / Non adapté à » sur cette page.
Comment rédiger un prompt pour Seed Audio 1.0 ?
Adoptez une structure de mise en scène : scène + intervenants + émotion + dialogue + ambiance / musique de fond / effets sonores + timing. Précisez qui parle et les caractéristiques de sa voix, placez les répliques entre guillemets, décrivez concrètement le lieu et la musique, et utilisez des plages comme [2.8s:8.4s] pour caler les moments clés. Les consignes vagues comme « make it cinematic » donnent de moins bons résultats : écoutez, précisez vos indications et relancez la génération.
Seed Audio 1.0 peut-il gérer un dialogue à plusieurs voix et des repères temporels en une seule prise ?
Oui, avec un brief de mise en scène : nommez chaque intervenant et chaque tour de parole dans un seul prompt, puis calez les moments clés avec des plages comme [2.8s:8.4s]. Les résultats varient ; vérifiez les chevauchements de voix et la prononciation, puis affinez vos indications. Cette version publique ne propose pas de mixeur multipiste distinct.
Mettez en scène des univers sonores plus riches avec Seed Audio.
Créations privées. Coût en crédits affiché avant de générer.
Rédigez un descriptif de scène en précisant les personnes qui parlent, l’ambiance et les indications sonores, puis lancez la génération avec Seed Audio 1.0 sélectionné.
Créer avec Seed Audio 1.0 ↑